가상 클러스터
개요
가상 클러스터는 여러 가상머신을 전용 고속 네트워크 패브릭으로 연결한 HPC 환경입니다. 대규모 분산 학습에서 GPU 간 통신 병목을 줄이는 데 사용합니다.
먼저 클러스터를 만들어 두고, 별도로 생성한 가상머신을 그 클러스터에 연결하는 흐름입니다.
Resource.VirtualCluster.CREATE권한 (가상머신 연결 시에는Resource.VirtualMachine.UPDATE도 필요)- 클러스터에 연결할 가상머신이 클러스터와 동일한 영역·동일한 인스턴스 유형이어야 합니다
- 클러스터 시작에는 최소 2개 이상의 가상머신이 필요합니다
패브릭 유형
가상 클러스터는 두 가지 네트워크 패브릭을 제공합니다.
| 패브릭 | 설명 |
|---|---|
| InfiniBand | InfiniBand 프로토콜 기반 전용 고속 네트워크. 최저 지연·최대 대역폭이 필요한 워크로드용 |
| Ethernet (RoCEv2) | RoCEv2 프로토콜 기반 전용 고속 네트워크. Ethernet 기반 환경 호환성 우선 |
선택은 워크로드 요구사항과 사용 가능한 인스턴스 유형에 따라 달라집니다.
1단계: 클러스터 생성
- 컴퓨트 > 가상 클러스터로 이동합니다.
- 우측 상단 가상 클러스터 생성 버튼을 클릭합니다.
- 아래 항목을 설정합니다.
| 항목 | 설명 |
|---|---|
| 클러스터 이름 | 식별 이름 |
| 가용 영역 | 클러스터가 배치될 영역 |
| 인스턴스 유형 | 클러스터 멤버에 사용할 인스턴스 유형 |
| 패브릭 유형 | InfiniBand 또는 Ethernet(RoCEv2) |
- 생성을 클릭합니다.
생성된 클러스터 자체는 빈 상태로 시작합니다. 멤버 가상머신은 별도로 생성한 후 클러스터에 연결합니다.
2단계: 가상머신 연결
클러스터에 추가할 가상머신은 같은 영역·같은 인스턴스 유형으로 생성해야 합니다.
- 컴퓨트 > 가상머신에서 멤버로 사용할 가상머신을 만들거나 기존 가상머신을 엽니다.
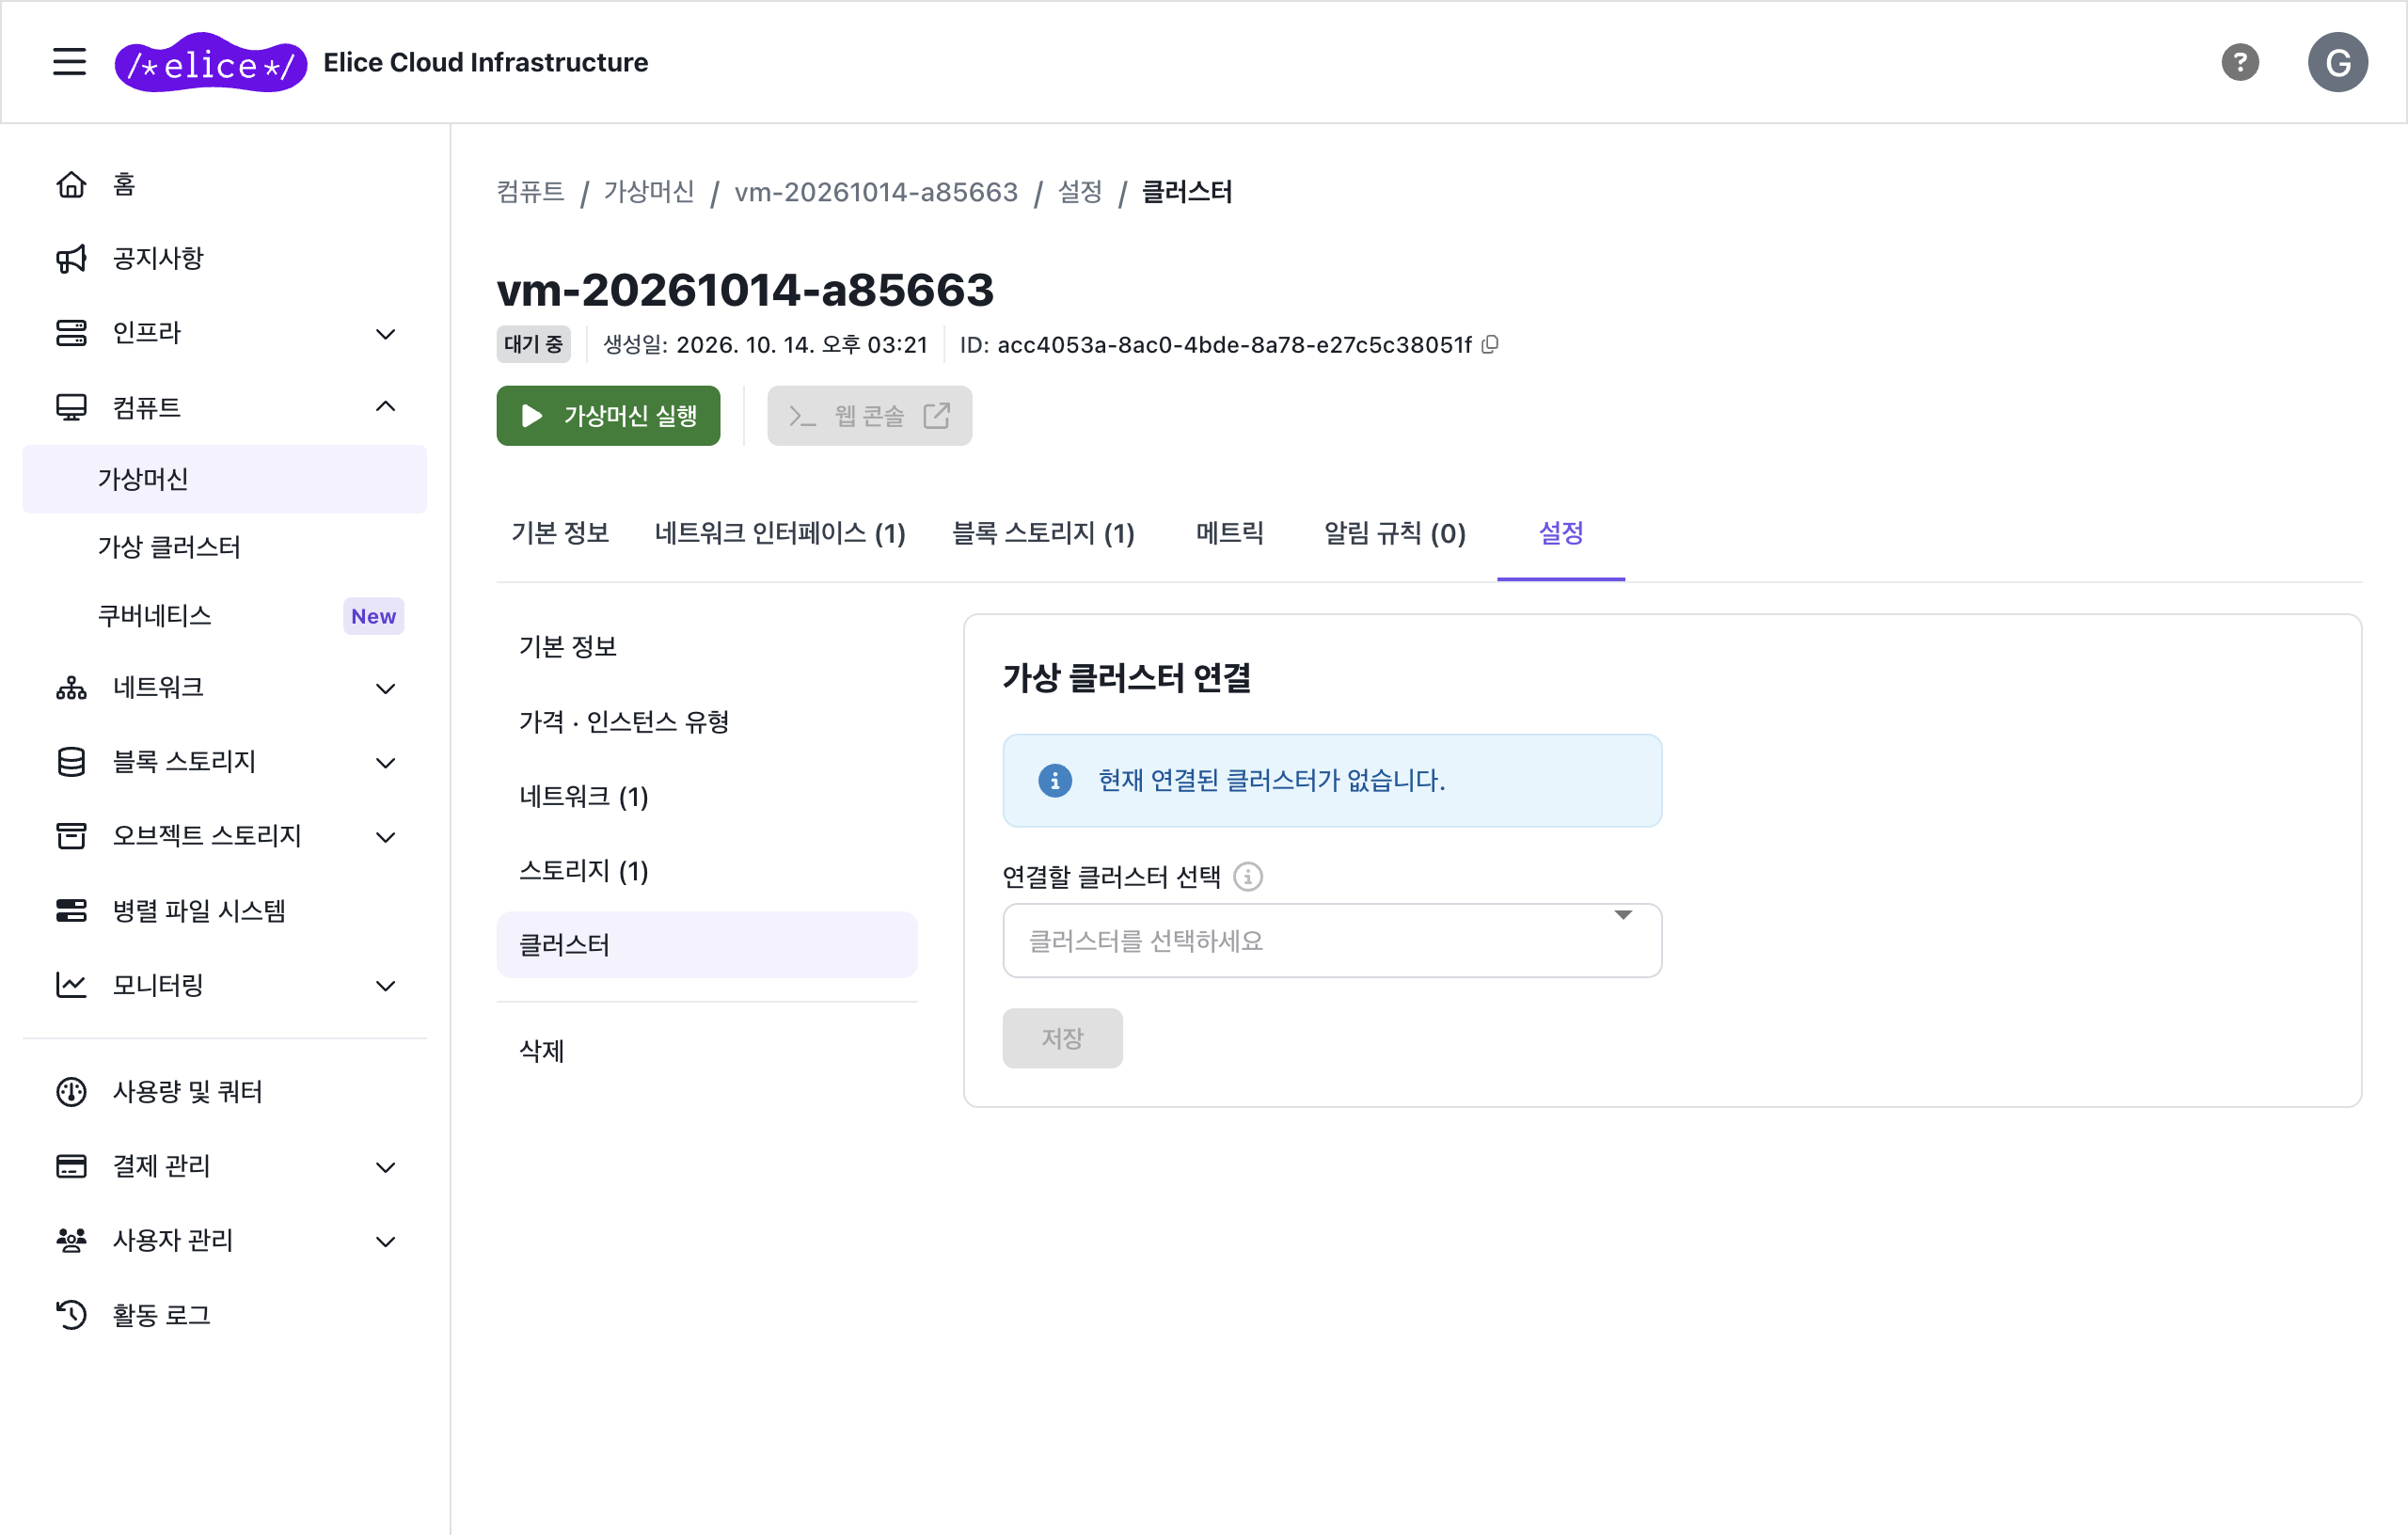
- 가상머신 상세 페이지의 설정 탭 > 클러스터로 이동합니다.
- 연결할 클러스터 선택에서 클러스터를 선택하고 저장을 클릭합니다. 같은 영역의 클러스터만 표시됩니다.
분리할 때는 같은 항목에서 클러스터에서 분리를 선택하고 저장합니다.
여러 가상머신을 한 번에 연결하거나 분리하려면 클러스터 상세 페이지의 연결된 가상머신 탭에서 가상머신 관리를 클릭해 대상 가상머신을 선택합니다.
가상머신은 대기 중 상태일 때만 클러스터에 연결할 수 있습니다 (포털 안내: "동일한 인스턴스 유형이며 중지된 상태의 가상머신만 연결하거나 해제할 수 있습니다"). 또한 스팟·재해 복구(DR) 가상머신은 클러스터에 연결할 수 없습니다.
3단계: 클러스터 시작
멤버 가상머신이 모두 연결되면 클러스터를 시작합니다.
연결된 멤버 가상머신이 2대 미만이면 클러스터를 시작할 수 없으며, 포털에 "클러스터를 시작하려면 최소 2개 이상의 가상머신을 연결해야 합니다." 안내가 표시됩니다.
- 컴퓨트 > 가상 클러스터 목록에서 대상 클러스터를 선택합니다.
- 상세 페이지에서 클러스터 시작을 클릭합니다.
- 상태가 실행 중으로 바뀌면 멤버 가상머신들도 개별 시작합니다.
중지는 클러스터 중지를 클릭합니다. 이때 실행 중인 가상머신이 있으면 먼저 모든 가상머신을 종료해야 합니다.
클러스터 상태
| 상태 | 의미 |
|---|---|
| 준비 중 | 프로비저닝 중 |
| 미할당 | 클러스터가 만들어졌지만 자원이 할당되지 않은 상태 |
| 할당됨 / 대기 중 | 자원이 할당되었으나 아직 실행 전 |
| 실행 중 | 클러스터 가동 중 |
| 종료됨 / 삭제됨 | 종료 또는 삭제된 상태 |
클러스터 상세 페이지
| 탭 | 내용 |
|---|---|
| 기본 정보 | 클러스터 이름, 패브릭 유형, 인스턴스 유형, 영역, 할당 정보 |
| 연결된 가상머신 | 멤버 가상머신 목록과 각 가상머신 상태 |
| 메트릭 | 클러스터 단위 GPU·CPU·네트워크·메모리 사용량 |
| 설정 | 클러스터 삭제. 실행 중인 클러스터는 삭제할 수 없으며, 삭제하면 연결된 가상머신이 분리됩니다 |
InfiniBand 사용
클러스터 시작 후 멤버 가상머신들은 패브릭으로 자동 연결됩니다. MPI 기반 분산 학습에서 GPU 간 통신에 활용합니다.
# InfiniBand 장치 확인
ibstat

# 멀티노드 PyTorch 분산 학습 예시 (torchrun)
torchrun --nproc_per_node=8 --nnodes=4 \
  --node_rank=0 \
  --master_addr=<마스터-가상머신-IP> \
  --master_port=29500 \
  train.py
자세한 설정·벤치마크는 InfiniBand 설정 및 벤치마크를 참고하세요.
사용 사례
- 대규모 LLM 사전학습: 수십~수백 GPU 분산 학습
- 멀티노드 파인튜닝: gradient 동기화 속도 향상
- HPC 과학 계산: MPI 기반 병렬 시뮬레이션
멤버 가상머신은 온디맨드 또는 약정형으로 생성하세요.
다음 단계
- InfiniBand 설정 및 벤치마크: 성능 검증 방법
- 병렬 파일 시스템: 멀티노드 학습용 공유 스토리지
- GPU ML 학습 환경 구성: CUDA·PyTorch 설치부터 학습까지